miércoles, 30 de enero de 2019

0

Tema 03 - Sesion 05 (29/01/19)

Esta sesión se trata de una continuación de la sesión anterior. Se va a tomar el canal de ThingSpeak creado en la sesión anterior y se van a graficar sus datos.

Dicha gráfica va a programarse mediante html usando para ello Notepad++ como editor y Google Charts como el servicio que creará la gráfica.

Notepad++ se trata de un editor de texto con  soporte para varios lenguajes de programación. En esta sesión se va a trabajar en html, combinándolo con JavaScript. Al trabajar con html hay que crear una suerte de "árbol" del que luego van "colgando" elementos. Así, dentro de <html>...</html> han de incluirse <head>...</head> y <body>...</body>.

Dentro de  <head>....</head> se van a incluir varios <script type="text/javascript">...</script> dentro de los cuáles irá el código en JavaScript. A su vez, dentro de <body>...</body> se va a incluir <div id="curve_chart"></div>.

El código: por partes
La primera línea de código relevante a analizar es la siguiente: <script type="text/javascript" src="https://www.gstatic.com/charts/loader.js"></script>

Con ella se le está indicando al html que tiene un script de tipo JavaScript, y que está en la URI https://www.gstatic.com/charts/loader.js Esto  significa que en cada ejecución se va a descargar el código JavaScript de esa URI, por lo que el código está lo más compactado posible. No tiene casi saltos de línea o espacios, y los nombres de las variables son lo más simples posibles: a, bc, e, etc.
 
El código que aparece en la página de Google Charts trabaja con datos estáticos. Sin embargo, en este caso se quiere trabajar con los datos provenientes de ThingSpeak. Para ello es necesario recuperar esos datos, por lo que se crea la función myCallback, y se utiliza para almacenar los datos.

<script type="text/javascript">
   var jsonData
   function myCallback(dataWeGotViaJsonp) {
     jsonData = dataWeGotViaJsonp['feeds'];
   };
</script> 

<script type="text/javascript" src="https://api.thingspeak.com/channels/[CHANNEL_ID]/feeds.json?api_key=[API_KEY]&results=10&callback=myCallback"></script>

Se observa que se añade &callback=myCallback a la URI. La URI está extraída del propio canal de ThingSpeak, y se trata del Get a Channel Feed que se tiene en la sección Data Import/Export de cada canal. 

El siguiente paso sería crear la gráfica, de nuevo usando JavaScript. Para ello se cargan las funciones tal como se indica en la guía de Google, pero se modifica la función de DrawChart de la siguiente manera:

function drawChart() {
  var data = new google.visualization.DataTable();
  data.addColumn('datetime','Time');
  data.addColumn('number','CPU');
  data.addColumn('number','RAM');
  for(var i=0; i<jsonData.length; i++) {
    var timestamp = jsonData[i]['created_at'];
    var cpu = jsonData[i]['field1'];
    var ram = jsonData[i]['field2'];
    data.addRow([new Date(timestamp), parseFloat(cpu), parseFloat(ram)]);
  };
  var options = {
    title: 'Computer performance', legend: {position: 'bottom'},
    curveType: 'function', colors: ['red','blue'],
    series: {0: {targetAxisIndex:0},1:{targetAxisIndex:1}},
    vAxes: {0: {title: '%CPU'},1:{title: '%RAM'}}
  };
  var chart = new google.visualization.LineChart(document.getElementById('curve_chart'));
  chart.draw(data,options);
}

Con data.addColumn se añaden los datos deseados, que en este caso son el tiempo, el %CPU y el %RAM. Mediante un for se cargan los datos de ThingSpeak a las variables timestamp, ram y cpu. A continuación se especifican las opciones, que serán las que darán el aspecto visual a la gráfica.

El código: resultados
Todo este código se encuentra dentro un archivo .html, con lo que para ver su resultado se puede abrir el fichero con el navegador.

LineCharts

Finalmente, el código completo está a continuación, donde solo habrá que editar los huecos indicados por [MAYÚSCULAS] según sea necesario.

lunes, 28 de enero de 2019

0

Tema 03 - Sesion 03 y 04 (24/01/19)


En la clase de hoy se ha hecho uso de la herramienta de programación Python para la realización de peticiones HTTP en ThingSpeak similar a lo realizado previamente. La sesión de hoy se va a dividir en dos ejercicios.


EJERCICIO 1: Visualización del uso de RAM y CPU del pc y envío de datos a ThingSpeak  

En este ejercicio, se va a realizar un programa en la herramienta Python que lea el consumo de CPU y RAM del ordenador para después subirlo a la red mediante la API REST que hemos visto con anterioridad, con un previo borrado del canal.

Lo primero de todo va a ser abrir Python y descargar la librería Psutil, que se realiza escribiendo en el terminal de la aplicación: pip install psutil. Este comando ejecuta la instalación directamente, sin necesidad de pasos adicionales. Una vez que esté instalada, estamos listos para la realización del ejercicio.  

En cualquier programa de Python, el primer paso es añadir las librerías:
import psutil
import httplib
import urllib
Estas tres librerías son las que van a permitir realizar, tanto la lectura del consumo, como las peticiones HTTP necesarias para subir los datos a la red.

A continuación, se debe realizar una conexión TCP al servidor deseado, por lo que se añade tanto la dirección del servidor como la definición de la conexión:

server = 'api.thingspeak.com'
connTCP = httplib.HTTPSConnection(server)
Write_apkey = 'GTXNVDI95SFSUDRQ'
Delete_apkey = 'KEJU9WAA6A7VQS2C'
Se pueden poner visualizaciones con print a modo de depuración, es decir, a la hora de ejecutar el código, se se ejecuta la linea print, significa que el programa hasta esa linea es correcto. Se realiza la conexión:
print("Estableciendo conexion TCP..."),
connTCP.connect()
print("Conexion TCP establecida")
Una vez realizada la conexión, debemos establecer las reglas del diálogo con el servidor. Empleando la información obtenida del REST API, se incluyen aquellos campos necesarios, que son el formato y la llave de escritura de la que disponemos en nuestra pagina de ThingSpeak.

En este código se puede ver el recurso DELETE, la URI relativa a la que apunta el programa, las cabeceras y el contenido del mensaje. Debido a que el contenido del mensaje es una librería Python que el servidor web puede no reconocer, se decodifica a json para realizar una petición que sí entienda.

La última línea sirve para añadir la longitud del mensaje en la librería de la cabecera.
methodC1 = "DELETE"
relative_uriC1 = "/channels/680589/feeds.json"
headersC1 = {'Host': server,
           'Content-Type': 'application/x-www-form-urlencoded'}
payloadC1 = {'api_key': Delete_apkey}
payload_encodedC1 = urllib.urlencode(payloadC1)
headersC1['Content-Length'] = len(payload_encodedC1)
Para realizar la conexión y el envío de la petición, se emplea el código a continuación:
connTCP.request(methodC1, relative_uriC1, body=payload_encodedC1, 
headers=headersC1)
respuestaC1 = connTCP.getresponse()
statusC1 = respuestaC1.status
print(str(statusC1))
El comando STATUS nos va a devolver el resultado de la conexión, siendo 200 una petición correcta.

Con esta petición, se ha solicitado el borrado del canal previo a la subida de los datos.
Una vez estén los datos borrados, se va a realizar una subida de nuevos datos, para lo cual se va a realizar una estructura WHILE que va a ejecutar indefinidamente el segmento siguiente:

try:
    while(True):
        cpuPercent = psutil.cpu_percent(interval=15)
        ramPercent = psutil.virtual_memory().percent

        print("%CPU: " + str(cpuPercent)),
        print("\t%RAM: " + str(ramPercent))

        method = "POST"
        relative_uri = "/update.json"
        headers = {'Host' : server,
                   'Content-Type' : 
                      'application/x-www-form-urlencoded'}
        payload ={'api_key' : Write_apkey,
                  'field1': cpuPercent,
                  'field2': ramPercent}

        payload_encoded = urllib.urlencode(payload)
        headers['Content-Length'] = len(payload_encoded)

        print("Enviando peticion HTTP..."),
        connTCP.request(method, relative_uri, body=payload_encoded, 
                        headers=headers)
        print("Peticion enviada")
        print("Esperando respuesta HTTP...")

        respuesta = connTCP.getresponse()
        status = respuesta.status
        print(str(status))
Con una estructura similar al borrado pero empleando el recurso POST, se envian los datos al servidor realizando la peticion HTTP.
Para detener la ejecución del programa, se presiona CTRL+C, y se adjunta una linea de comandos para la realización de una secuencia de apropiada, junto con el cierre de la conexión:

except KeyboardInterrupt:
    connTCP.close()
    print("Se ha pulsado CTRL+C. Saliendo del programa")


EJERCICIO 2: Creación de un canal, subida de datos y borrado del canal al finalizar

En este ejercicio, como indica en el título, se va a crear un código que cree un canal, obtenga la información necesaria para subir datos a ese canal, y después borrarlo a la salida de la ejecución. El código es el siguiente:

sábado, 26 de enero de 2019

0

Tema 03 - Sesión 03, Preparación (24/01/19)

La tercera sesión de esta asignatura será doble y en ella se trabajará con peticiones HTTP, Thingspeak y Python. Con el objetivo de preparar la sesión, se han mandado una serie de ejercicios para terminar de afianzar lo explicado en las sesiones 1 y 2

Ejercicio 01: Envío de datos con formulario
En la URI http://august-outlet-228919.appspot.com/ hay un formulario que permite obtener la letra de un DNI. Se pide: 

a ) Ver qué es lo que ocurre cuando se solicita la URI anteriormente indicada. 
Se obtiene un código 302: redirige a https://august-outlet-228919.appspot.com/html/form.html
 
b) Introducir un DNI válido y ver a qué URI se envía la petición.
La petición se envía a https://august-outlet-228919.appspot.com/obtener Letra. Como tiene espacio, en la petición este se convertirá en un %

c) Obtener los siguientes parámetros:
  • Nombre del parámetro asociado al DNI: nan
  • Nombre y el valor de los parámetros ocultos adicionales: ezkutua: kalkulatu

d) Editar manualmente en Burp la petición HTTP para obtener la letra y comprobar que la respuesta HTTP contiene la letra en el cuerpo del mensaje.
La petición a enviar será de la forma:

POST /obtener%20Letra HTTP/1.1
Host: august-outlet-228919.appspot.com
Content-Type: application/x-www-form-urlencoded
Content-Length: [largura_mensaje]

nan=22725983&ezkutua=kalkulatu

Donde [largura_mensaje] deberá sustituirse por el valor adecuado en cada caso. Burp lo rellena automáticamente. El valor de nan también deberá modificarse a conveniencia.

Petición de letra
Respuesta entregada por el servidor

Ejercicio 02: Enviar datos en formato formulario a ThingSpeak y recibir una respuesta vacía
Siguiendo la documentación de Matlab para trabajar con ThingSpeak se hace la petición desde Burp Suite. El canal a actualizar es el ya creado durante la sesión número 02. El formato de la petición será:  

POST /update HTTP/1.1
Host: api.thingspeak.com
Content-Type: application/x-www-form-urlencoded
Content-Length: [largura_mensaje]
api_key=[channel_api_key]&field1=[valor_campor_1]&field2=[valor_campo_2] 

  • [channel api_key] habrá que sustituirlo entero por el api_key del canal.
  • [valor_campor_1] y [valor_campor_2]: se deberán sustituir por lo valores que se quieren subir al canal.
  • [largura_mensaje]: se deberá sustituir por la largura del mensaje (depende de cada caso y Burp lo rellena automáticamente)
La respuesta entregada por el servidor así como los datos actualizados en el canal pueden observarse a continuación:

Respuesta del servidor: está vacia


Ejercicio 03: Enviar los datos en formato formulario y recibir una respuesta en formato JSON
De nuevo, la petición será de la forma: 

POST /update.json HTTP/1.1
Host: api.thingspeak.com
Content-Type: application/x-www-formurlencoded
Content-Length: [largura_mensaje]

api_key=[channel_api_key]&field1=[valor_campor_1]&field2=[valor_campo_2]

La respuesta entregada por el servidor así como los datos actualizados en el canal pueden observarse a continuación:

Respuesta del servidor

Ejercicio 04: Enviar los datos en formato JSON y recibir una respuesta en formato XML
Esta vez la petición se hace en formato json, con lo cual cambia un poco su aspecto respecto a las veces anteriores 

POST /update.xml HTTP/1.1
Host: api.thingspeak.com
Content-Type: application/json
Content-Length: [largura_mensaje]


{"api_key":"[channel_api_key]","field1":=[valor_campo_1],"field2":=[valor_campo_2]} 

La respuesta entregada por el servidor así como los datos actualizados en el canal pueden observarse a continuación:
Respuesta del servidor


martes, 22 de enero de 2019

0

Tema 03 - Sesión 02 (17/01/19)

En esta sesión, se ha introducido una nueva herramienta de análisis de datos:


Es una plataforma abierta basada en el principio IoT que hace uso de MatLAB para la recopilación y análisis de datos en la nube, teniendo una opción gratuita y otra de pago.

En nuestro caso se ha elegido la gratuita, que únicamente permite subir datos limitados en cantidad y tiempo, cada 15 segundos máximo. Sin embargo, para nuestro uso educacional es suficiente. El funcionamiento de este sistema es sencillo.

Los dispositivos proncipales son Smart Devices conectados a la red, los cuales recopilan datos de cualquier tipo. Estos datos, se suben directamente a este servidor en la nube, en el cual se pueden visualizar y analizar directamente desde el navegador web. Como añadido, estos datos se pueden descargar a MatLAB para realizar análisis mas detallados.

A continuación, veremos como se suben los datos a la plataforma web:

CHARTS 

Los datos almacenados se organizan de manera muy sencilla en las tablas de datos. Esto es una representación visual que es accesible desde cualquier plataforma, y tiene el siguiente aspecto:


Para introducir los datos aquí, debemos hacer uso de una API específica: 
REST API
Rest API es un entorno de programación de aplicaciones basado en MatLAB que permite realizar ciertas operaciones respecto a la base de datos ThingSpeak. Podemos encontrar diferentes apartados como los siguientes:
En este primer acercamiento, nos vamos a centrar en la subida de datos a la nube. Para ello, se han creado dos tablas vacías e idénticas a las del ejemplo previo.
Se puede realizar mediante dos funciones, GET o POST, pero nos vamos a centrar en POST en este ejemplo. La especificación API define como hay que realizar la petición de envió de datos, la cual se puede realizar de la siguiente manera, empleando el programa BurpSuite, mencionado en anteriores artículos.
Primero se va a apuntar a la dirección web apropiada:

La siguiente va a ser la realización del envío de información, para lo cual empleamos la REST API mencionada previamente. Dicho esto, la petición queda de la siguiente manera: 

Como es una petición de escritura, se adjunta en el cuerpo la clave privada de escritura. Una vez realizado todo esto, se observa el resultado:

Como el valor recibido de la petición es 200, todo esta correcto, y el dato se ha cargado completamente.

domingo, 20 de enero de 2019

0

Tema 03 - Sesión 01 (15/01/19)

En la sesión del martes 15 de enero se introdujeron los conceptos de HTTP básicos.

MODELO CLIENTE SERVIDOR
HTTP se trata de un protocolo que sigue un modelo cliente-servidor: permite que un cliente indique las operaciones a realizar sobre un recurso que ya se encuentra en un servidor. Es decir, el cliente realiza peticiones, el servidor las procesa y devuelve respuestas.

Las peticiones HTTP van a ir encapsuladas en una conexión TCP, de esta forma se asegura una la entrega de los datos en secuencia y sin errores. Por otro lado, una conexión TCP viene identificada por el par (IP_Origen – Puerto_Origen)-(IP_Destino-Puerto_Destino).

Todas las aplicaciones de un ordenador tienen un puerto, que le permite al ordenador saber a dónde mandar los paquetes que llegan de Internet.

RECURSOS
La razón por la que las acciones se ejercen sobre recursos, es porque estos son la base sobre la que está montado lo que conocemos comúnmente como Internet. Así, una misma página que está formada por multitud de recursos.

Las operaciones/métodos que se pueden realizar sobre un recurso son las siguientes:
  • Post: permite escribir.
  • Get: Permite leer
  • Put: permite actualizar
  • Delete: permite borrar   
Cada uno de los recursos sobre los que se ejercen las operaciones está identificado con su propia URI dentro del servidor, que intercambia las representaciones de dichos recursos. El hecho de que se intercambien las representaciones es porque u recurso puede tener más de una representación: una página web no se ve igual en el móvil que en el ordenador, aunque esté formada por los mismos recursos en ambos casos.

TRANSACCIONES
Cada operación ejercida sobre un recurso genera transacciones. Cada transacción es independiente de las anteriores y las siguientes, y por ello en servicios que trabajan con logins se usan las cookies. Estas cookies permiten agregar cabeceras a esas transacciones, de forma que aunque siguen siendo independientes, se sigue manteniendo la sesión. 

Para cargar una página web que a simple vista puede parecer sencillas, se están realizando multitud de transacciones en unos pocos milisegundos. Por ejemplo, solo para cargar la página principal de Google se realizan 9 transacciones-. Sin embargo, para cargar la cuenta de Gmail, se realizan más de 200, que además aumentan de forma constante por estar haciendo peticiones continuas al servidor para mantener la bandeja de entrada actualizada.


PETICIÓN DE UN CLIENTE HTTP
La sintaxis de una petición HTTP es la siguiente: 

Método RequestURI HTTP/1.1
Cabeceras
CRLF*
Cuerpo del mensaje (en octetos**)


La única cabecera obligatoria siempre va a ser Host. Otras cabeceras pueden incluir información sobre preferencias de que el contenido esté comprimido o no, su idioma o formato. En general, el orden de las cabeceras no va a ser relevante para el servidor que lee la petición. Si el recurso solicitado existe en el servidor y se le pueden realizar las acciones solicitadas, a continuación el servidor va a leer las cabeceras. De esta forma podrá devolver el recurso de la manera que mejor se adapte a lo solicitado por el cliente.

RESPUESTA DE UN SERVIDOR HTTP
La sintaxis de la respuesta va a ser la siguiente:

HTTP/1.1 Status Descripción
Cabeceras
CRLF
Cuerpo del mensaje (en octetos)

Se profundizará mas en ello en la próxima sesión.

EJERCICIO BURP 
Para poner en práctica lo explicado en clase, se realiza un sencillo ejercicio en el Burp Suite. El objetivo del mismo es solicitar l página principal de Google. 
El primer paso es configurar el Target, asignando un Host y un puerto. Como es HTTP, no HTTPS, puerto 80.


A continuación, se realiza la petición. El método va a ser GET. Como se quiere la página principal, el recurso será /. El Host es el mismo que el target, y finalmente se deja la línea en blanco necesaria.

Si es correcto la respuesta devolverá un 200.
  
Sobre los códigos de respuesta también se hablará más en la próxima sesión.


viernes, 18 de enero de 2019

0

Tema 02: el e-Learning


En esta segunda parte de la asignatura se ha introducido el concepto de e-learning. Como ingenieros e ingenieras, vamos a enfrentarnos a una industria que está sufriendo una resolución. Aparecen nuevas herramientas, programas y sistemas. Por ello, la formación de un profesional de cualquier rama nunca esta completa, si no que hay que seguir aprendiendo y desarrollándose.

A tales efectos surgen plataformas de aprendizaje online como Coursera, edX, Udacity o MiríadaX. Muchos de los cursos ofrecidos por estas plataformas vienen de universidades de gran prestigio a nivel mundial, y hasta ofrecen títulos oficiales si accedes a hacer los cursos no gratuitos.

Este tipo de aprendizaje, eso sí, no es adecuado para todo el mundo. Como da mucha libertad, se depende únicamente de la voluntad de uno mismo para sentarse y aprender. A cambio, es un método muy eficaz para aprender programación, a usar ciertos programas y plataformas o incluso comenzar a estudiar un idioma (y descubrir si nos gusta tanto como para iniciar un aprendizaje más serio y de muchos más años).

Además, algunas plataformas como Coursera o edX están empezando a ofrecer grados y  masters online. Aunque esto no sea nada nuevo, ya que en España la UNED lleva funcionando desde 1972. Sin embargo, ahora se abre el abanico de posibilidades, no solo a grados si no a países, universidades o idiomas de impartición.

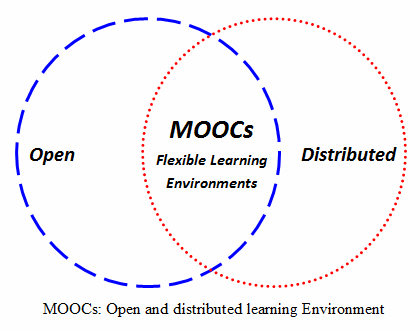
Este tipo de plataformas mencionadas se consideran MOOCs, lo que significa que son cursos online abiertos y masivos. Esta es una de las grandes diferencias de estas plataformas con otras más clásicas como la UNED. No se trata únicamente de usar un sistema como Moodle del que descargar los apuntes y preparar el examen.
En su lugar se tienen unos videos pregrabados, ejercicios y exámenes, y todo esto se realiza a la vez que miles de otros usuarios cursando exactamente el mismo curso, aunque cada uno esté en un punto diferente del mismo. Esto hace que muchas de las tareas a entregar puedan ser revisadas mediante un sistema de P2P o peer to peer, en el que compañeros corrigen y valoran el trabajo entregado. Además de ello, un mismo usuario puede estar apuntado a tantos cursos como desee, ya que en general estos suelen ser cortos aunque requieran de una dedicación semanal constante.

Se puede decir, por tanto, que el e-Learning es la nueva forma de aprender, y que los MOOC pueden ser el gran aliado del trabajador, sobre todo cuando se trata de querer mejorar unas habilidades concretas que puedan permitir el acceso a puestos de trabajo más especializados.

lunes, 14 de enero de 2019

0

Análisis video

Se trata de realizar el análisis crítico de uno de los siguientes vídeos.

El video elegido se trata de “cómo matar al Intermediario”, de Hernán Casciari. 

 
Se trata de una charla TED. Las TED Talks son conferencias a nivel mundial, donde los ponentes tienen 20 minutos para tratar su tema. Los temas tratados suelen estar relacionados con ciencia, tecnología, educación, sociología, etc.

Es más, este video pertenece un TEDx, lo que significa que se deben cumplir algunos principios:
  • El congreso no debe tener ánimo de lucro, y los conferenciantes no cobran.
  • Los conferenciantes renuncian a los derechos de copyright, y permiten que TED los edita y distribuya bajo licencia Creative Commons. 
  • Se trata de una colaboración abierta para poner cultura y servicios a disposición del público, sin importar si han colaborado en la generación de los mismos o no.
Estos tres puntos están relacionados con algunos de los aspectos que trata Hernán en su charla, sobre la distribución de contenidos y el acceso a los mismos.

Dando comienzo al análisis, lo voy a realizar desde dos puntos de vista. En el primero, muy brevemente, voy a hablar de la capacidad comunicativa de Hernán durante la propia charla. Durante el segundo, más extenso, me voy a centrar en los temas y cuestiones que está exponiendo en dicha charla.

En lo que se refiere a su habilidad comunicativa, se puede ver que depende únicamente de lo que está diciendo. No usa medios multimedia como fotos o vídeos, y tampoco le hacen falta. Usa un lenguaje sencillo y directo: trata el tema relacionándolo con anécdotas de su vida e intercalando chistes y comentarios.

Esto le hace parecer más cercano y facilita que se le preste atención. Por otro lado, es capaz de contar todo lo que necesita en el tiempo establecido, sin tener que correr ni simplificar explicaciones. En general, se trata de un buen ponente, capaz de transmitir, aunque no esté usando las herramientas más modernas que pudiera tener a su alcance.

En lo que se refiere a la charla en sí, Hernán comienza hablando de cómo creó un blog en el que iba subiendo historias. Este blog, que nunca fue publicitado por empresas de marketing y que fue dándose a conocer por el boca a boca, acabó por crear una gran comunidad activa e internacional. Podríamos decir que el éxito de este blog se basaba en dos pilares importantes, y que deberían ser la clave de todo blog exitoso.
  • Se estaba creando un contenido gratuito y de calidad, con un tema constante (es decir, los propios cuentos).
  • Se generaba una interacción: el propio Hernán contestaba los comentarios, generando así un feedback que animaba a más gente a comentar.
Es este punto donde empezaron sus problemas: editoriales y periódicos con un modelo de negocio tradicional le convencieron de que se uniera a ellas.

Es aquí donde se ponen de relieve las primeras diferencias. Los blogs basan su éxito en el feedback y el contenido gratuito. En un modelo tradicional de publicación, estas dos ideas no existen. De hecho, se rehúye de ellas: tradicionalmente los autores en raras ocasiones han interactuado directamente con sus seguidores, y todo su contenido debe generar un valor monetario (para las editoriales, claro, raras son las personas capaces de vivir únicamente de la escritura).

Esto acaba por generar unos problemas que antes Hernán no tenía:
  • Recibe un porcentaje irrisorio de las ganancias generadas con su contenido (mientras que los distribuidores e intermediarios reciben muchísimo más).
  • La distribución es mucho peor que antes, haciendo que algunos de los seguidores del blog ya no tengan acceso a sus nuevos contenidos.
Es decir, al desaparecer las ideas básicas que dieron tanto éxito a su blog, el sistema deja de ser exitoso. Por ello, Hernán decide renunciar a dichas editoriales e inicia una cadena de proyectos personales, entre los que se incluyen una revista, una editorial y varios bares.

Todos estos proyectos se basan en renunciar constantemente a los intermediarios. La publicidad se hace con el boca a boca, el dinero se obtiene mediante donaciones, la distribución la realiza la propia comunidad. Además de ello, todo ese contenido también se puede obtener de forma gratuita, favoreciendo así el concepto de “cultura libre y gratuita”, pero en la que los creadores (escritores e ilustradores), son compensados de forma justa por su trabajo.

Es decir, en 2011 Hernán se había dado cuenta de algo que muchas empresas en pleno 2018 aún gastan millones en entender. Aunque él estuviera usando una plataforma virtual, y aunque la comunidad no estuviera físicamente presente, esta existía de verdad.

Es decir, Hernán trató a las personas como personas, y no como avatares en una pantalla: habló con ellos, les invitó a participar de sus ideas, fue sincero y no intentó sacarle el dinero a nadie por la cara. Gracias a esto creó un sistema en el que la propia comunidad era a la vez la consumidora y la financiadora del contenido, y de forma voluntaria.

Podría concluirse, por tanto, que para Hernán las claves para acabar con el intermediario son:
  • Tener un contenido.
  • Crear un feedback.
  • No centrarse en el beneficio económico.
  • No tener miedo a compartir contenido (ya sean cuentos, programas, investigaciones, canciones, etc).
Para finalizar me gustaría mencionar que una conocida página web que sigue estas mismas ideas es Wikipedia, la quinta web más visitada del mundo. Y todo ello sin ánimo de lucro, dependiendo de donaciones voluntarias, y siendo su contenido creado por los propios usuarios. Está claro que no es el mejor sistema para hacerse rico, pero sí el más efectivo para crear comunidades activas y duraderas.

domingo, 13 de enero de 2019

1

Sobre este blog

- ¿Quién lleva este blog?
Aintzane MS y Unai629, alumnos de la escuela de ingeniería de Bilbao.

- ¿Qué es este blog?
Este blog es una de las tareas a entregar para la asignatura de "Aplicación de las TICs en investigación". Sirve como memoria para recoger lo aprendido durante buena parte de la asignatura. Esa es la principal razón por la cual no hay una periodicidad clara de actualizaciones, ni secciones, ni artículos ni nada propio de un blog de divulgación normal y corriente.

- ¿Qué es eso de "Aplicación de las TICs en investigación?
Se trata de una de las asignaturas optativas del tercer cuatrimestre del master INCAR de la UPV/EHU.

- ¿Qué es el master INCAR?
Es el máster de "Ingeniería de control, automatización y robótica" que ofrece la Universidad del País Vasco.  

- ¿La tarea del blog, en qué consiste?
Además de documentar parte de la asignatura, el blog debe tener una serie de características en lo que se refiere al diseño. Por ello, debe tener 8 gadgets, siendo obligatorios Archivo del blog, Etiquetas, Páginas, Buscador y Calendario. 

1. Archivo del blog: se encuentra en la columna izquierda.
2. Etiquetas: en la columna derecha.
3. Páginas: barra de navegación tras el banner del blog. Se trata de una pequeña modificación del css del blog combinado con un gadget html.
4. Buscador: en la barra de navegación. Modificación del css del blog combinado con un gadget html.
5. Calendario: columna derecha.


6. Botones redes sociales: a la derecha del banner. Mediante el código html del blog se dividió el espacio reservado por defecto al header, permitiendo así la inclusión de otro gadget.


7. Perfil: columna izquierda.


8. Subscripción via mail: en la columna derecha, bajo el calendario.

Con esto ya se habría cumplido el mínimo necesario de 8 gadgets. Sin embargo, con el objetivo de mejorar el diseño y la funcionalidad del blog se han añadido otros. Algunos de ellos son Visitas, un gadget html con la licencia creative commons o Seguidores.
También se ha modificado el css en otros casos, para combinarlo con gadgets html y conseguir las siguientes prestaciones:

9. "Sobre la autora/autor" en las entradas.
10. Flecha que permite subir arriba en caso de haber descendido mucho en el blog.

11. Modificación del aspecto de los comentarios.

ir arriba